
 Pik Performans
 Bellek Bant Genişliği
 Provizyon Süresi
 Uzman GPU Desteği
 HIZLANDIRILMIŞ HESAPLAMA
İşlem Gücünü İhtiyacınız Kadar Kullanın
GPU kaynağını satın almadan, proje takviminize göre açıp kapatıyorsunuz.

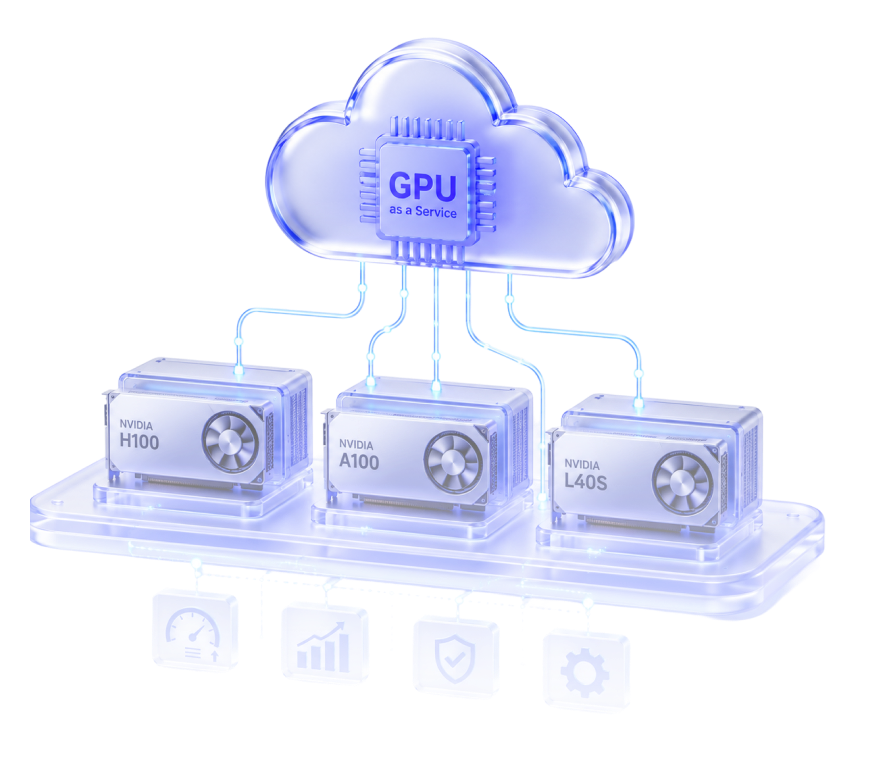
NVIDIA H100, A100 ve L40S hızlandırıcılar üzerinde çalışıyorsunuz. Büyük dil modeli eğitiminden gerçek zamanlı inference’a kadar farklı iş yükleri için doğru kartı seçiyorsunuz.

Ayrılan GPU’lar yalnızca sizin iş yükünüze tahsis ediliyor. Model verileriniz ve ağırlıklarınız izole bir ortamda, Türkiye’deki veri merkezimizde kalıyor.

Yüz binlerce liralık donanım yatırımı yerine kullandığınız saat kadar ödüyorsunuz. Eğitim biten gün kaynağı kapatarak proje bütçenizi kontrol ediyorsunuz.

Portal üzerinden GPU örneğini açıyor, iki dakikanın altında çalışmaya başlıyorsunuz. Donanım tedarik süresi, kurulum ve sürücü hazırlığı sizin gündeminize girmiyor.

Sanallaştırma katmanının araya girmediği, doğrudan donanım üzerinde çalışan seçenekle tam performans alıyorsunuz. Çok GPU’lu eğitim işlerinde kartlar arası bant genişliğinden tam olarak yararlanıyorsunuz.
GPU kümeniz, Storage as a Service üzerindeki eğitim veri setinize aynı altyapı içinden erişiyor. Veri setini dışarı taşımadan çalıştığınız için hem süre hem transfer maliyeti düşüyor.
PERFORMANS KATMANLARI
GPU Küme Seçenekleri
Her iş yükü en güçlü kartı gerektirmez; doğru katman, hem süreyi hem maliyeti belirler. İnference ve render tarafında L40S, büyük ölçekli eğitimde A100 ve H100 kümeleri devreye girer. Hangi katmanın uygun olduğunu model boyutunuz ve hedef süreniz üzerinden birlikte belirliyoruz.
362 TFLOPS, 48 GB GDDR6, 864 GB/s. Gerçek zamanlı inference, video render ve grafik işleme.
624 TFLOPS, 80 GB HBM2e, 2.0 TB/s. Büyük ölçekli AI eğitimi, veri analitiği ve bilimsel hesaplama.
989 TFLOPS, 80 GB HBM3, 3.35 TB/s. LLM eğitimi ve transformer tabanlı modeller.
Uzun süreli projeler için tek kiracılı, size tahsis edilmiş küme.
KULLANIM ALANLARI
GPU Gücünü Nerede Kullanıyorsunuz?
Hesaplama süresi projenin takvimini belirleyen iş yükleri için.
Yazılım ve SaaS
Medya ve Prodüksiyon
Otomotiv
Sağlık
Finans ve Sigorta
Üretim ve Sanayi  HESAPLAMAYA BAŞLAYIN
GPU Kümenizi Bugün Ayağa Kaldırın
Model boyutunuzu ve hedef sürenizi paylaşın, uygun GPU katmanını ve tahmini çalışma maliyetini birlikte belirleyelim.
Ekibimiz en kısa sürede sizinle iletişime geçecektir.